Agenten-Dashboards mit MotherDuck Dives: React + SQL statt BI-GUI
Mein Evidence-Setup hat eine ehrliche Schwäche: Die Zahlen sind so alt wie der letzte Build. MotherDuck Dives drehen das Prinzip um – die Queries laufen beim Öffnen live gegen die Datenbank, die Facettierung danach im Browser. Dieser Beitrag erklärt den Unterschied zwischen Build-Zeit und Lauf-Zeit, rechnet die Kosten durch und zeigt einen live deployten Eigenbau-Dive mit echtem MotherDuck-Backend – 300 Zeilen React + SQL, kein BI-Tool.
Stand: September 2026 · Autor: Thomas Ebermann · Lesedauer: ca. 14 Minuten
TL;DR
In meinem letzten Beitrag habe ich gezeigt, wie Sie mit Evidence, DuckDB und Claude Dashboards als Code bauen – open source, mit Hosting Kosten die nahe null sind und versioniert wie Software. Und ich habe dort eine Schwäche eingeräumt, die ich heute zum Hauptthema mache: Ein Evidence-Dashboard ist eben leider nur so aktuell wie sein letzter Deploy. Es ist statisch, und wird nicht aktualisiert.
Genau hier setzen MotherDuck Dives an: Dives sind auch in Code geschreibene Dashboards, deren Queries beim Öffnen live gegen die Datenbank laufen und deren Facettierung dann im Browser des Anwenders in Millisekunden rechnet. Dieser Beitrag erklärt den Architektur-Unterschied zwischen den beiden Dashboard und rechnet durch, was Dives kosten (ja, ein Abo braucht es – aber kein Per-Seat-Modell), und sagt ehrlich, wann ich welches Werkzeug einsetzen würde.
Die eine Schwäche, die mein Evidence-Setup hat
Zur Erinnerung, wie das Evidence-Setup aus dem letzten Beitrag funktioniert: Ein Dashboard ist eine Markdown-Datei mit SQL-Blöcken. Beim npm run build läuft jede Query einmalig gegen die Datenquelle, die Resultate landen als Parquet-Dateien in der statischen Site, und der Browser zeigt diese vorkompilierten Daten an. Die Deployment-Doku von Evidence sagt es auch ganz direkt: Die Daten werden nur dann aktuell, wenn man sie neu baut. Evidence ist im Grunde ein Static-Site-Generator. Das hat natürlich auch manchmal Vorteile: In der Vorstandssitzung will niemand die Zahl, die sich zwischen Folie 3 und Folie 7 ändert. Und mit Build-Crons (nightly, wöchentlich) ist der Datenstand praktisch gut genug.
Aber es hat eban auch Nachteile:
- Alt sein vermeiden. Zwischen Build und Öffnen liegen Stunden bis Tage. Wer um 16:47 wissen will, was heute Morgen verkauft wurde, schaut dann in die Röhre.
- Frei drillen. Die Filter, die ich eingebaut habe, funktionieren – aber sie rechnen nur auf der eingefrorenen Datenmenge umher. Eine neue Schnitt-Dimension (etwa «Umsatz nach Kanton statt Land») ist ein dann eben Code-Change plus Build und kein Klick. Das kann als nervig empfunden werden.
- Wachsen mit der Frage. Jede neue Frage der Geschäftsleitung landet erst im Chat-Verlauf (z.B. beim nao-Agent) und wird erst beim nächsten Build zum Dashboard.
Was Dives anders machen: Build-Zeit vs. Lauf-Zeit
Die Architektur unterscheidet sich also bei beiden Dashboards:
Evidence (Build-Zeit): Hier läuft die Query Build, das Resultat wird dann eingefroren. Jeder Seitenaufruf zeigt dann dasselbe eingefrorene Resultat. Die Daten sind dann eben so frisch wie der letzte Deploy.
Dive (Lauf-Zeit): Beim Öffnen des Dives laufen die Queries live auf dem MotherDuck-Compute gegen den aktuellen Stand des Warehouse. Die Resultate werden in eine DuckDB-Instanz im Browser gestreamt – DuckDB als WebAssembly, dieselbe Engine, die wir lokal lieben, nur eben in der Browser-Sandbox. Die Facettierung läuft danach lokal. d.h. das Zeitfenster wechseln, Land filtern, in einen Bereich hineinzoomen – alles rechnet gegen den frisch geladenen Datensatz im eigenen Browser, in einstelligen Millisekunden, ohne einen einzigen Roundtrip zur Datenbank. Das ist schon recht cool.
Das Ergebnis dieser Zweiteilung ist bemerkenswert: Das Dashboard ist beim Öffnen nie stale (Datenabruf live), aber die Interaktion kostet trotzdem kein Warehouse-Compute pro Klick (Facettierung lokal). MotherDuck nennt das Dual Execution, und in meinen eigenen Tests mit rund 200’000 Zeilen bleibt ein kompletter Filter-Durchlauf unter 20 Millisekunden – dazu unten mehr. Das alles hat auch einen Preis, und der ist nicht nur der Abo-Betrag:
- Compute bei jedem Öffnen. Ein statisches Evidence-Dashboard kostet pro View exakt nichts. Ein Dive verbraucht Warehouse-Compute, sobald jemand es öffnet. Im Gratis-Plan sind das 10 Compute-Stunden pro Monat – für ein internes Dashboard reicht das, für 500 Kunden-Embeddings natürlich nicht (dazu gleich).
- Die Zahlen verändern sich unter Ihren Füssen. Der Vorstand sieht 09:00 einen Wert, um 11:00 einen anderen. Reproduzierbarkeit muss man sich bei Live-Daten anders sichern – etwa mit fixen Stichtagen in den Queries.
- Daten liegen in der Cloud. Ein Dive zeigt nur, was im MotherDuck-Warehouse liegt. Wer On-Prem-Pflicht hat, für den ist die Diskussion hier zu Ende – Evidence auf eigener Infrastruktur ist dann wieder attraktiv.
Auch Evidence selbst hat die Konvergenz Richtung Live längst vollzogen. Auf der Homepage verkauft die Firma inzwischen einen Analytics Agent (live im Chat, per Slack und MCP) und eine Embedded-Analytics-API.
Was ein Dive überhaupt ist
Kurz zum Produkt selbst, weil die Bedeutung im Hype untergeht: Ein Dive ist eine interaktive Data App, bestehend aus React und SQL. Kein proprietäres JSON-Chart-Format wie bei klassischem BI, sondern ein React-File mit eingebetteten, auditierbaren SQL-Queries. Versionierbar in Git, reviewbar per Pull Request, deploybar mit CI. Das ist exakt die «BI-as-Code»-Philosophie aus meinem Evidence-Beitrag, nur mit mehr Interaktivität unter der Haube.
Der Bauablauf ist agentenbasiert: Über den MotherDuck MCP Server sagt man dem Agenten der Wahl (Claude Code, ChatGPT, Cursor), was man sehen will, iteriert in natürlicher Sprache («Ersetze die Pie-Charts durch Sparklines») und publiziert den Dive in den Workspace. Wichtig für Skeptiker: Der Agent generiert den Code einmalig – was dann läuft, ist deterministische Web-App-Software mit nachvollziehbaren Queries, kein LLM, das bei jedem Seitenaufruf neu fantasiiert. Die Charts laufen standardmässig auf Recharts, D3 ist inklusive, und Libraries werden ins Sandbox-Bundle gepackt statt live aus dem Internet nachgeladen – verständlich, wenn die App mit einer Warehouse-Verbindung im Browser hantiert.
Zwei Einordnungspunkte noch:
- Embedding. Dives lassen sich als gesandboxtes iframe in die eigene App einbetten. Das eigene Backend hält den Admin-Token und stellt pro Session einen kurzlebigen Token aus – danach redet der Browser direkt mit MotherDuck, ohne Middleware-Server dazwischen. Kein eigenes Charting-Frontend, das man pflegt, und (siehe unten) keine Per-Viewer-Lizenz.
- React. In der Dive Gallery finden Sie Beispiele, die kein Click-and-Drag-BI-Tool abbilden würde: ein Pivot-Explorer mit einem im Dive generierten Semantic Model in Malloy, oder ein interaktiver Globus, über den man Erdbeben zeitlich scrubt und Regionen cross-filtert. Das schöne daran: Es gibt keine Werkzeug-Grenze, eher nur eine Aufwandsgrenze. Das weniger schöne: Der Aufwand, ein eigenes React-App-Design zu pflegen, ist eben auch nicht null – wobei sich der Agent darum kümmern soll, nicht Sie.
Was es kostet: ja, ein Abo braucht es – aber kein Per-Seat-Modell
Dives sind kein Open Source. Das Feature hängt an MotherDucks Infrastruktur (serverseitigem Compute und Storage); mit reinem OSS-DuckDB ist es nicht abbildbar – das WASM-Teil schon, dazu unten. Die aktuelle Preisliste:
| Plan | Preis | Was drin ist |
|---|---|---|
| Lite | 0 CHF | 10 GB Storage, 10 Compute-Stunden/Monat, 3 interne User. Dives für interne Dashboards inklusive. |
| Business | ab USD 250/Org./Monat + Usage | 10 interne User, Storage 0.04 USD/GB, Compute ab 0.60 USD/Stunde. Embedded Dives (für Ihre eigene App) laufen ab hier bzw. Enterprise. |
| Enterprise | individuell | Unbeschränkte User, PrivateLink, Fixpreis-Kapazität. |
Das Wichtigste ist im Modell dass es keine Per-Seat-Lizenzen. hat. Klassisches Embedded-BI rechnet pro Viewer ab d.h. wenn Ihre App wächst oder Sie viele Kleinkunden haben, explodiert die Rechnung. Bei MotherDuck zahlen Sie Compute und Storage, und der Browser des Anwenders erledigt die Interaktion auf eigener Hardware, gratis. Für den Einstieg reicht die Gratis-Testphase (ohne Kreditkarte), Startups kriegen motherduck.com/startups gratis Credits. Und für alle, die Dives für mehrere Kunden bauen: pro Kunde einen eigenen MotherDuck-User mit gleich benannter Database – serverseitig wird pro User isoliert gerechnet, und da die Plattform serverless ist, kostet ein stiller Kunden-Account nichts.
Selbst ausprobieren: ein Dive im Eigenbau
Theorie ist schön, aber funktioniert das auch? Ich wollte es wissen und habe das Dive-Prinzip lokal nachgebaut: dieselben PulsCheck-Demodaten wie im Evidence-Beitrag (rund 200’000 Zeilen über 5 Tabellen), diesmal als React-App mit DuckDB-WASM im Browser. Das Herzstück ist eine einzige Datei mit sämtlichen Queries – auditierbar, versionierbar, exakt die Dive-Philosophie:
-- src/queries.js (Auszug): KPIs im gewählten Zeitfenster
select
  (select round(sum(p.price_chf), 2)
     from pulscheck.response_packages p
     join pulscheck.customers c on c.id = p.customer_id
     where cast(p.purchased_at as timestamp)
             >= timestamp '2026-05-01' - to_days(${days})
       and ${ownerCountry(country)}) as window_revenue_chf,
  ...
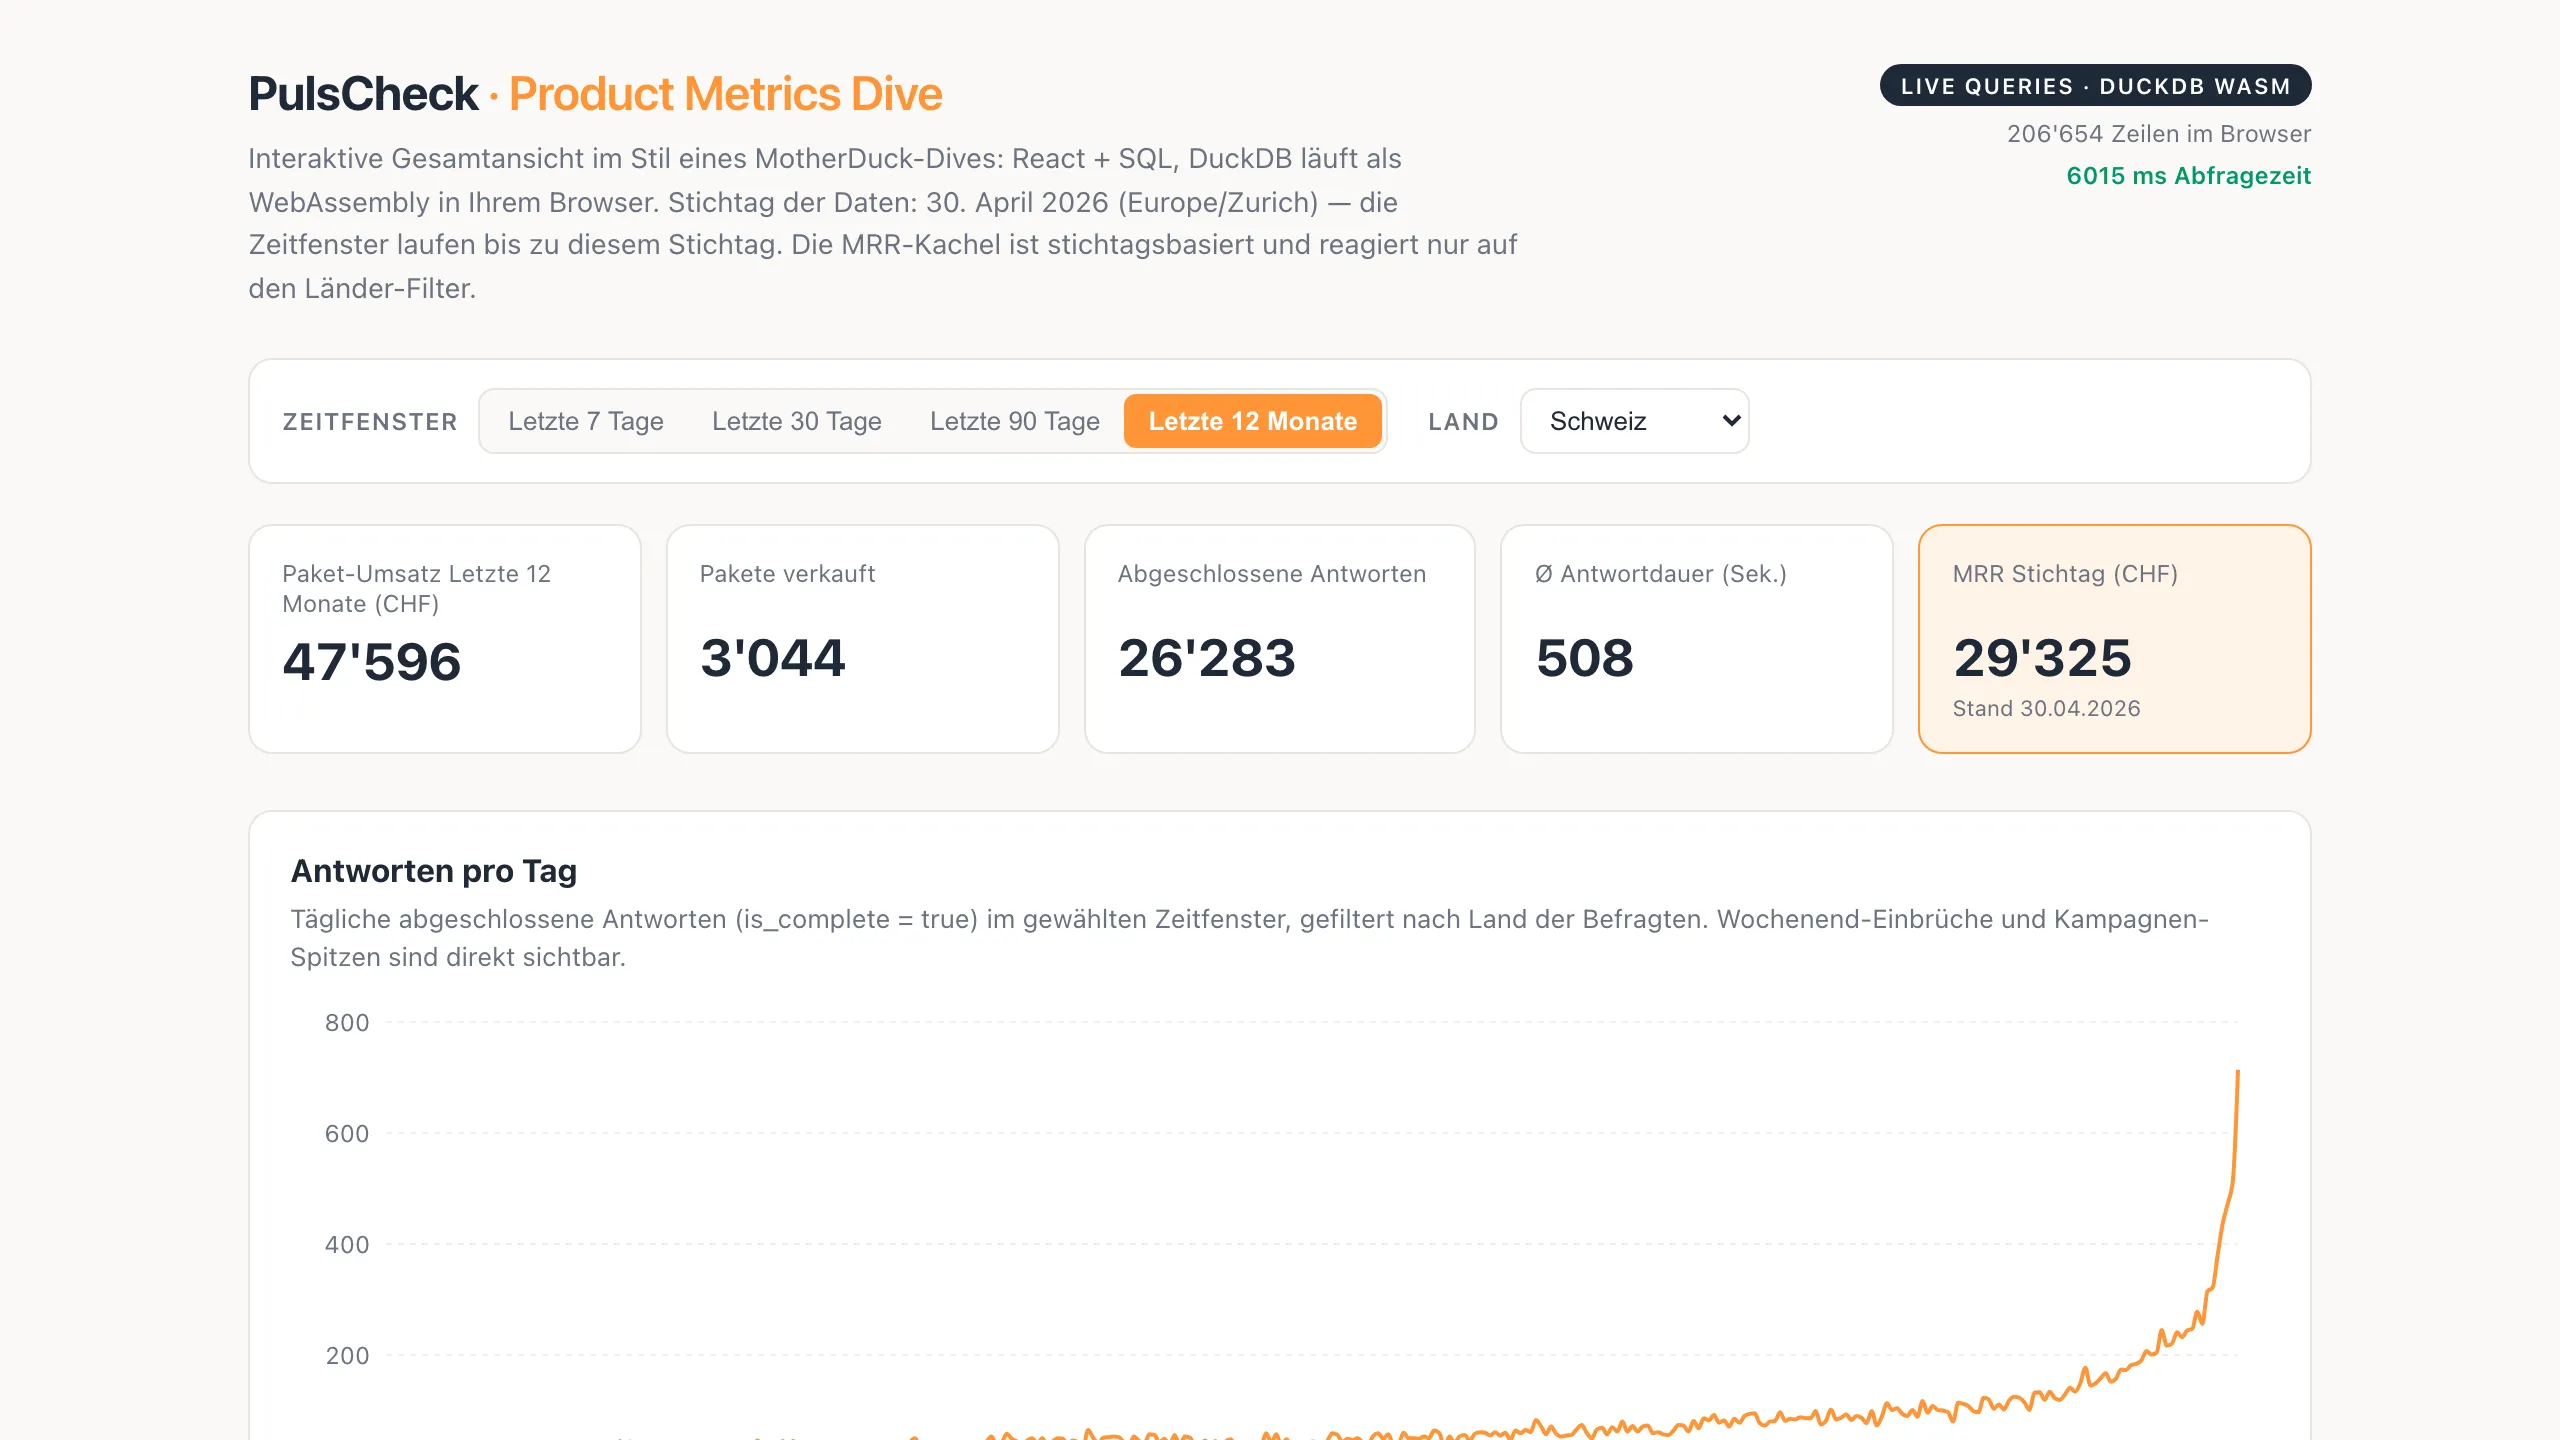
Das UI: Zeitfenster-Umschalter (7/30/90/365 Tage), Länder-Filter, fünf KPI-Kacheln, Zeitreihen-Charts (Recharts, wie bei Dives üblich), klickbare Paketgrössen-Chips als Cross-Filter, Geo- und Top-Kunden-Sichten.
Der Browser verbindet sich beim Öffnen via @motherduck/wasm-client direkt mit dem MotherDuck-Workspace. Die 9 initialen Queries laufen gegen das Live-Warehouse (Compute auf MotherDucks Seite), das Resultat wird in die Browser-WASM-Engine gestreamt. Danach – jeder Filterwechsel, jeder Chip-Klick – rechnet lokal in einstelligen Millisekunden, ohne Roundtrip. Das ist exakt das Dual-Execution-Prinzip.
Der für mich wichtigste Befund: Die Zahlen sind deckungsgleich mit der Evidence-Version. 26’927 abgeschlossene Antworten im April, 16’875 CHF Paket-Umsatz, 57’331 CHF MRR zum Stichtag – beide Implementierungen, dieselben Queries in der Logik, identisches Resultat. Das ist die eigentliche Message: Es ist egal, ob Evidence, Dive oder eigenes React-Frontend – wer ein sauberes Query-Set und klare Geschäftsregeln hat (bei uns die RULES.md), kann das Frontend beliebig austauschen.
Statt Fly.io Deployment auf der Motherduck Platform
Ich habe zunächst beim Deployment auf Fly.io gesetzt. Doch das war alles andere als trivial. Damit es überhaupt funktionierte, brauchte es: ein Dockerfile mit Multi-Stage-Build, eine nginx-Konfiguration mit COOP/COEP-Headern (DuckDB-WASM braucht SharedArrayBuffer, der Browser verlangt dafür spezifische Cross-Origin-Policies), ein Entrypoint-Script, das den MotherDuck-Token zur Laufzeit in eine config.js schreibt, fly secrets set für den Token, und schliesslich fly deploy. Und natürlich mindestens einen Debugging-Rundgang.
Die native Alternative existiert, und sie ist radikal einfacher: Ein Dive lebt in einer einzigen TypeScript-Datei. Lokale Iteration läuft mit npm run dev (Vite, Hot Reload, echte MotherDuck-Verbindung), Publishing läuft mit einem einzigen MCP-Tool-Call – save_dive. MotherDuck übernimmt das Hosting, setzt die richtigen COOP/COEP-Header und verwaltet die Token-Ausstellung. Kein Server, kein Docker, kein fly.toml.
Der Vergleich in Zahlen:
| Weg | Was man anfasst | Zeit bis «es läuft» |
|---|---|---|
| Fly.io Eigenbau | Dockerfile, nginx.conf, entrypoint.sh, fly.toml, fly secrets, MIME-Bug-Debugging | 1–2 Stunden |
| Nativer Dive | dive.tsx, npm run dev, save_dive via MCP | < 10 Minuten |
Das hat auch etwas mit dem Agenten-Workflow zu tun. Claude Code schreibt die Dive-Komponente direkt gegen die echte MotherDuck-API (via MCP-Server), iteriert lokal, und speichert mit einem einzigen Tool-Call in den Workspace. Der gesamte Prozess – vom ersten Query bis zum live deployten Dashboard – lief ohne einen einzigen manuellen Terminal-Befehl ausser npm run dev. Das ist die eigentliche Produktivitätsdifferenz: Bei Fly.io debuggt man Infrastruktur, bei nativen Dives debuggt man das Dashboard.
Der native Dive läuft direkt in MotherDuck: PulsCheck – Product Metrics Dive →
Der vollständige Quellcode – dive.tsx, der lokale Preview-Shim md-sdk.tsx und das Vite-Scaffold – liegt öffentlich auf github.com/plotti/pulscheck-dashboards im Verzeichnis .dive-preview/src/. Der Fly.io-Eigenbau (Dockerfile, nginx, queries.js) liegt im selben Repo unter dive/.
Was man dabei evtl. aufgibt: Fly.io bietet Custom Domains, volle Kontrolle über den Auth-Layer, und das Hosting läuft auf der eigenen Infrastruktur. Die native Dive-URL lebt auf app.motherduck.com. Für interne Tools ist das kein Nachteil. Für ein gebrandetes Kunden-Portal nimmt man das iframe-Embed – aber dann ist das Token-Management ohnehin anders gestaltet. Die Lektion: Den Fly.io-Weg zu gehen war lehrreich – er hat gezeigt, wie die Dual-Execution-Architektur unter der Haube funktioniert. Aber als Produktionsweg für jemanden, der MotherDuck bereits als Warehouse nutzt, ist er unnötig. Wer schnell iterieren will, nimmt den nativen Dive-Weg.
Dives vs. Evidence
| Evidence (Open Source) | MotherDuck Dives | |
|---|---|---|
| Datenstand beim Öffnen | Build-Zeit – stale bis zum nächsten Build | Live beim Öffnen; Facettierung danach lokal im Browser |
| Lizenzkosten | 0 CHF | Lite gratis, für Embedded USD 250+/Monat |
| Compute pro View | keiner | Warehouse-Compute bei jedem Öffnen |
| Daten liegen | bei Ihnen (z. B. DuckDB-File) | bei MotherDuck (Cloud-Warehouse) |
| Reproduzierbarkeit | fixer Snapshot pro Build (Feature!) | muss in den Queries gesichert werden (fixe Stichtage) |
| Interaktivität | gebaute Filter auf eingefrorenen Daten | freie Exploration, einstellige Millisekunden |
| Embedded Analytics | Eigenbau bzw. Evidence-Embedded-API | iframe mit kurzlebigem Token, Backend hält nur den Admin-Token |
| Vendor Lock-in | keins | vorhanden (Feature an MotherDuck gebunden) |
| Baustil | Markdown + SQL, Agent generiert | React + SQL, Agent generiert |
Aus meiner Sicht ist die erste Zeile die einzige, die eine Kaufentscheidung wirklich trägt. Alle anderen Zeilen sind entweder Folgen der ersten (Compute pro View gibt es nur, weil live geöffnet wird) oder Details, die beide Werkzeuge ähnlich gut lösen.
- Kuratierte interne Reports mit fixen Stichtagen, Kosten nahe null, Daten bleiben im Haus: Evidence. Bleibt meine Open-Source-Antwort für das klassische Reporting-KMU – die Reproduzierbarkeit ist dort ein Feature.
- Interne Exploration, wenn die Frage beim Build noch nicht bekannt war: Dives sollte man im Lite-Plan ausprobieren, das geht sogar gratis, und das WASM-Gefühl muss man einmal erlebt haben, um zu verstehen, was ich meine.
- Kunden-facing Analytics im eigenen Produkt: Hier hat Dives für mich das beste Gesamtkonzept – iframe-Embed mit kurzlebigen Tokens, kein Per-Seat, keine eigene Charting-Wartung. Voraussetzungen: Die Daten dürfen ins MotherDuck-Warehouse, und ein Business-Abo ist eingeplant. Die Alternative aus dem Evidence-Lager (Embedded-API) ist einen Blick wert, relativ jung ebenfalls.
- Regulatorisch kritische Daten, die die Firma nicht verlassen dürfen: Beide Cloud-Optionen fallen aus. Evidence on-prem bleibt die entspannteste Antwort.
Fazit: Snapshot vs. Live-Stream
Drei Erkenntnisse zum Mitnehmen:
Erstens: Die Datentabelle ist nicht das Dashboard. Meine Evidence-Dashboards und mein Eigenbau-Dive teilen sich dasselbe SQL, dieselben Geschäftsregeln, dieselben Zahlen – was sie unterscheidet, ist ausschliesslich, wann die Queries laufen. Build-Zeit heisst reproduzierbar und gratis, Lauf-Zeit heisst aktuell und interaktiv.
Zweitens: React + SQL ist das Markdown des Dashboards. Beide Tools bestätigen denselben Trend: Dashboards sind Code, Agenten schreiben den Code, Menschen reviewen ihn. Was sich ändert, ist nur das Ausführungsmodell – statischer Build hier, Browser-WASM mit Live-Datenabruf dort.
Drittens: Der Context Stack bleibt der eigentliche Hebel. Ob Evidence oder Dive – die Qualität des Resultats hing bei uns nie vom Charting-Tool ab, sondern von der RULES.md, dem Datenmodell und dem Realitätscheck gegen die echte Datenbank. Der kann in eine Dive genauso einziehen wie in eine Evidence-Pipeline.
Ich freue mich auf Ihre Kommentare und Anregungen!
Quellen und weiterführende Ressourcen
Diese Blog-Serie:
- Agentic BI für KMU in der Praxis: Ein Schweizer SaaS-Fall mit nao – der Context-Stack-Anfang
- The unreasonable effectiveness of Agentic Dashboards – Evidence, DuckDB und Claude, der Vorgänger-Beitrag
MotherDuck Dives:
- PulsCheck – Product Metrics Dive (live) – der native Dive aus diesem Beitrag
- PulsCheck Eigenbau auf Fly.io (live) – die Fly.io-Version zum Vergleich
- Quellcode auf GitHub –
.dive-preview/src/(nativer Dive) unddive/(Fly.io-Eigenbau) - Dives Product Page – Überblick, Live-Dive, Dual-Execution-Beschreibung, FAQ
- Dive Gallery – Community-Dives zum Hineinkopieren
- MotherDuck Pricing – Pläne, Limits, Compute-Preise (Stand September 2026)
- MotherDuck for Startups – Credits-Programm
Evidence:
- evidence.dev – Product-Überblick (inkl. Analytics Agent und Embedded-API)
- Evidence Deployment-Doku – Datenaktualisierung via Build
Technischer Hintergrund:
- DuckDB und DuckDB-WASM – die in-process Engine, auch als WebAssembly im Browser
- Recharts – die React-Charting-Library, die auch Dives defaultmässig nutzen
Dieser Beitrag basiert auf einem eigenständigen Nachbau mit synthetischen Demodaten (die PulsCheck AG ist – wie im Vorgänger-Beitrag beschrieben – ein zusammengesetztes Beispiel). Die Datapeople-Datenredaktion arbeitet mit Schweizer KMU an Datenarchitektur und Analytics. Feedback an hello@datapeople.ch.